6. D'où viennent les chiffres macro ? Sources, fréquence et fiabilité
· Mis à jour le · 18 min de lecture
Un matin de milieu de mois, 8 h 29 à Washington : les salles de marché se taisent, les algorithmes sont armés. À 8 h 30, le Bureau of Labor Statistics publie l'inflation américaine du mois écoulé — une fraction de seconde plus tard, des machines l'ont lue, comparée au consensus, et des dizaines de milliards de dollars ont changé de mains. D'où sort-il, ce nombre qui suspend la respiration des marchés ? D'un institut de statistique, où enquêteurs et programmes ont pendant des semaines relevé des dizaines de milliers de prix, agrégés, corrigés, pondérés, puis gardés sous scellés jusqu'à l'embargo. Le chiffre le plus attendu de la planète financière n'est pas une lecture de la réalité : c'est un produit manufacturé — matières premières, délais, défauts de série, et un service après-vente qu'on appelle les révisions.
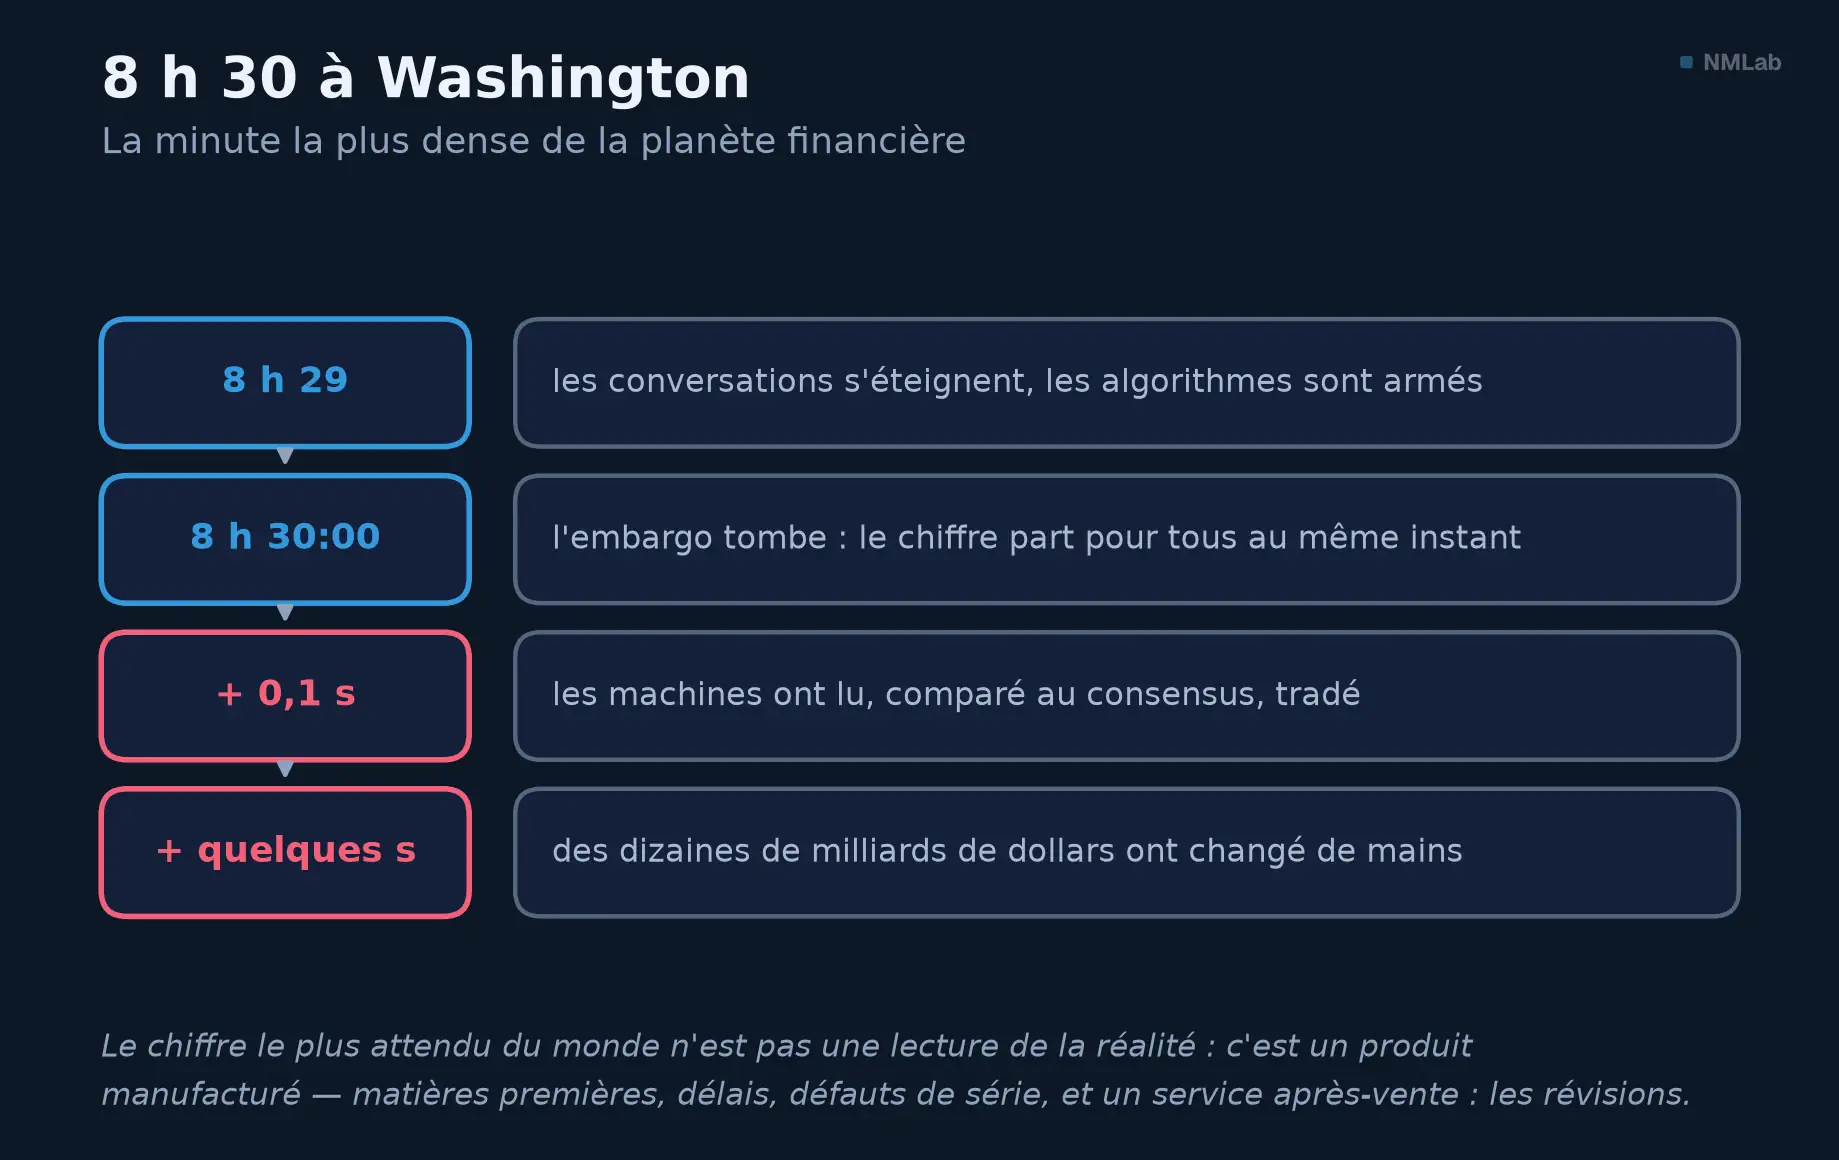
La minute de publication qui rythme ce chapitre.

Ce chapitre répond à cinq questions : qui fabrique les chiffres macro ? à partir de quoi ? à quel rythme ? pourquoi changent-ils après coup ? et jusqu'où s'y fier ? Réponse courte : ce sont des estimations — datées, échantillonnées, révisables —, produites par des institutions dont l'indépendance est fragile, et livrées selon un calendrier si régulier qu'il rythme les marchés comme une liturgie. Les respecter sans les vénérer : voilà la compétence à installer.
Repères — Niveau : Intermédiaire · Prérequis : chapitre 5
À la fin de ce chapitre, vous saurez :
- qui fabrique les chiffres macro, à partir de quoi, et pourquoi ils sont révisés des années durant ;
- lire une marge d'erreur — et pourquoi la surprise que le marché célèbre est parfois plus petite que le flou de la mesure ;
- distinguer une statistique imparfaite mais honnête d'une statistique sous influence.
Des chiffres fabriqués, au sens noble du terme
Le PIB n'existe pas dans la nature : personne n'a jamais croisé un taux de chômage dans la rue. Ces grandeurs sont des constructions statistiques — des conventions qui définissent un concept (qu'est-ce que « produire » ? « chercher un emploi » ?), puis des dispositifs qui tentent de le mesurer. Entre la réalité et le chiffre s'intercalent des choix humains : ce qu'on compte, ce qu'on ignore, comment on interroge et corrige.
Ces constructions sont récentes : au début des années 1930, en pleine Grande Dépression, le gouvernement américain pilotait à l'aveugle. Le Congrès commanda à Simon Kuznets la première comptabilité du revenu national ; son rapport de 1934 fonda ce qui deviendrait le PIB, et la guerre en fit un outil d'État. Au même moment, Richard Stone bâtissait en Grande-Bretagne la norme internationale des comptes nationaux ; les deux reçurent le Nobel. Or, dès 1934, Kuznets prévenait le Congrès que le bien-être d'une nation ne se déduit guère du revenu national : le père du PIB fut le premier à en borner le sens.
Conséquence longtemps tue : une mesure bâtie sur enquêtes et conventions porte une marge d'erreur, comme en physique — or les chiffres économiques sont tradés à la décimale près. Oskar Morgenstern en fit un livre classique, On the Accuracy of Economic Observations : aucun physicien ne publierait une constante sans son intervalle d'incertitude. Un chiffre n'est pas exact parce qu'il est officiel : il est utilisable — défini publiquement, produit méthodiquement, corrigé honnêtement. L'exactitude vient par approximations successives.
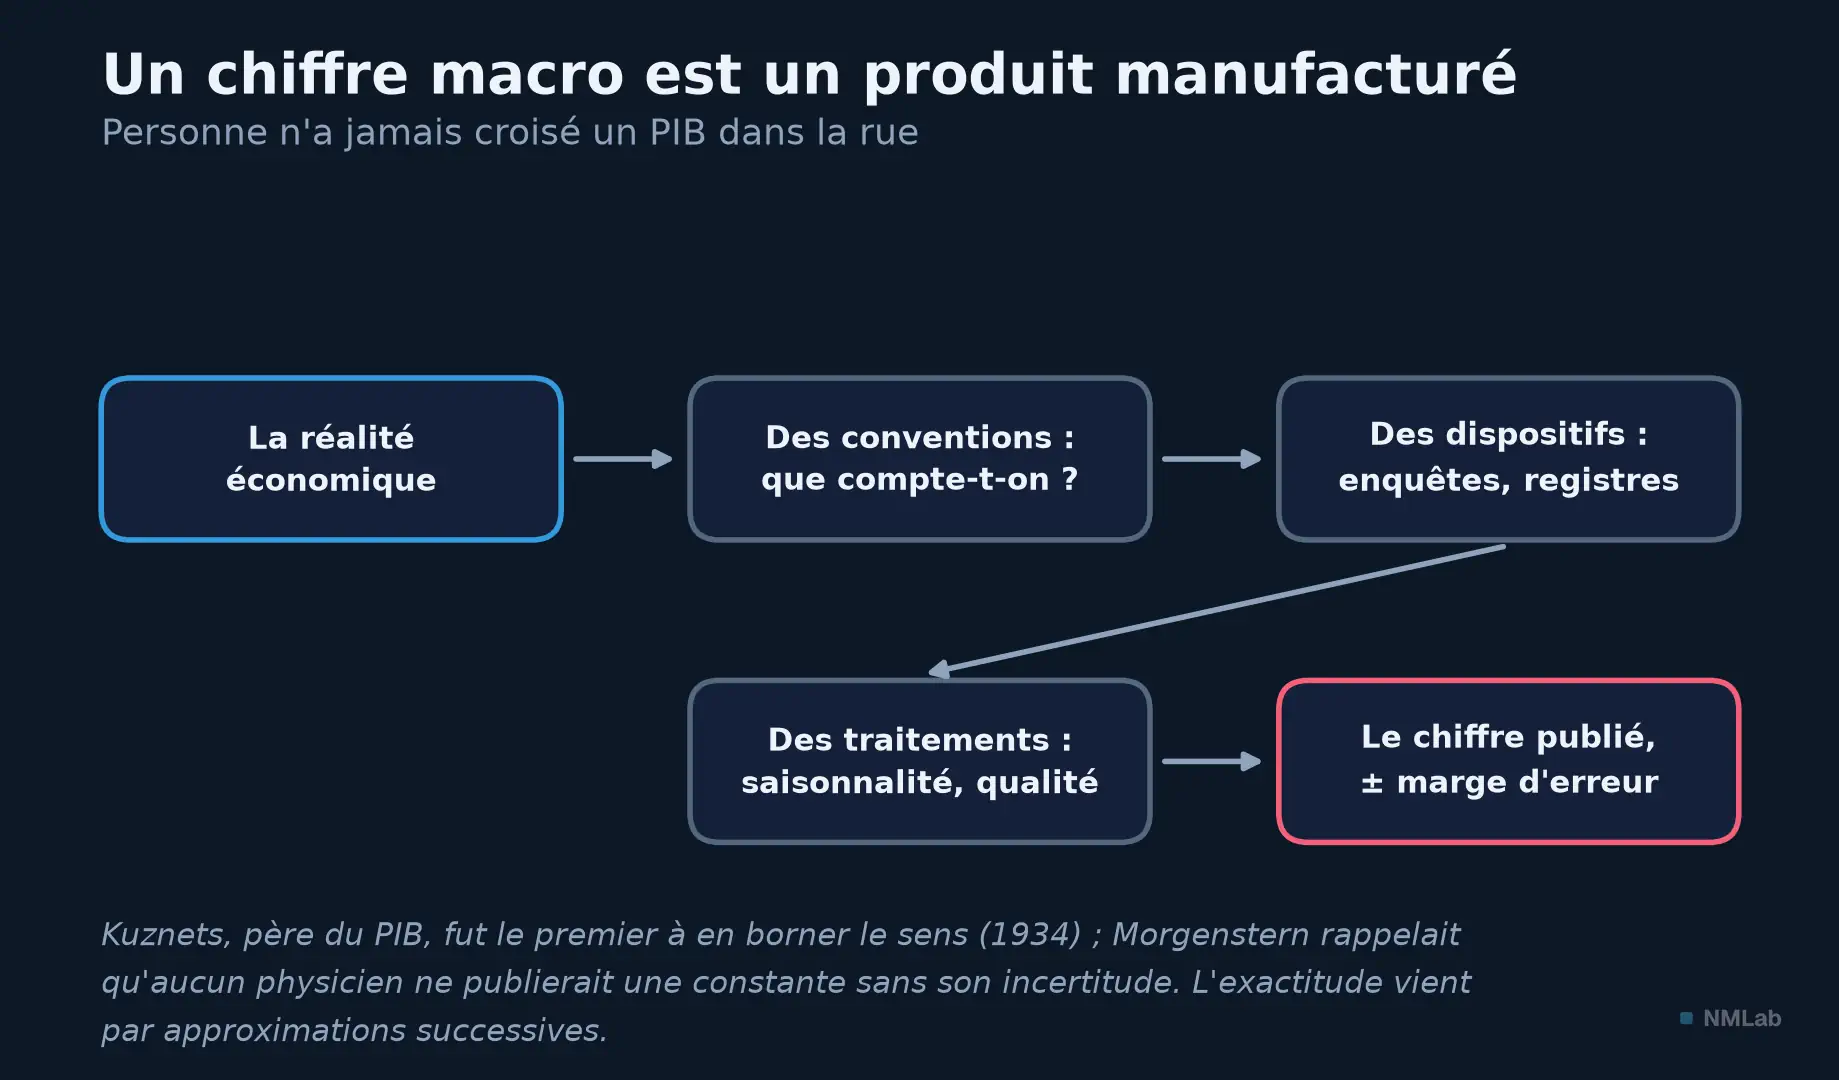
De la réalité au chiffre : conventions, dispositifs, traitements — et une marge d'erreur en sortie d'usine.
Qui fabrique quoi : la carte des producteurs
Remontez la piste d'un chiffre : vous tombez presque toujours sur un institut national — INSEE en France, Destatis en Allemagne, ONS au Royaume-Uni —, coiffé par Eurostat pour la zone euro. Aux États-Unis, la piste se divise : le Bureau of Labor Statistics (BLS) produit l'emploi et les prix à la consommation, le Bureau of Economic Analysis (BEA) le PIB et l'inflation PCE, le Census Bureau les ventes au détail, le logement et le commerce extérieur. Trois guichets pour un même tableau de bord.
Les banques centrales, elles, produisent autant qu'elles consomment : la Réserve fédérale publie la production industrielle et les comptes financiers, la BCE les statistiques monétaires et bancaires. Au-dessus, les organisations internationales — FMI, OCDE, Banque mondiale, BRI — collectent peu mais comparent les pays et fixent des normes. Restent les producteurs privés, la famille sous-estimée : l'ISM interroge les directeurs d'achats depuis les années 1930, S&P Global publie ses PMI dans des dizaines de pays, le Conference Board et l'université du Michigan (depuis 1946) sondent le moral des ménages. Ces enquêtes ne mesurent pas l'activité mais des réponses — un jugement, une intention. C'est la partition déjà croisée dans le panorama : données molles (opinion, tôt et trompeuses d'humeur) contre données dures (activité réalisée, tard et fiables). L'investisseur utilise les deux, en sachant laquelle il lit.
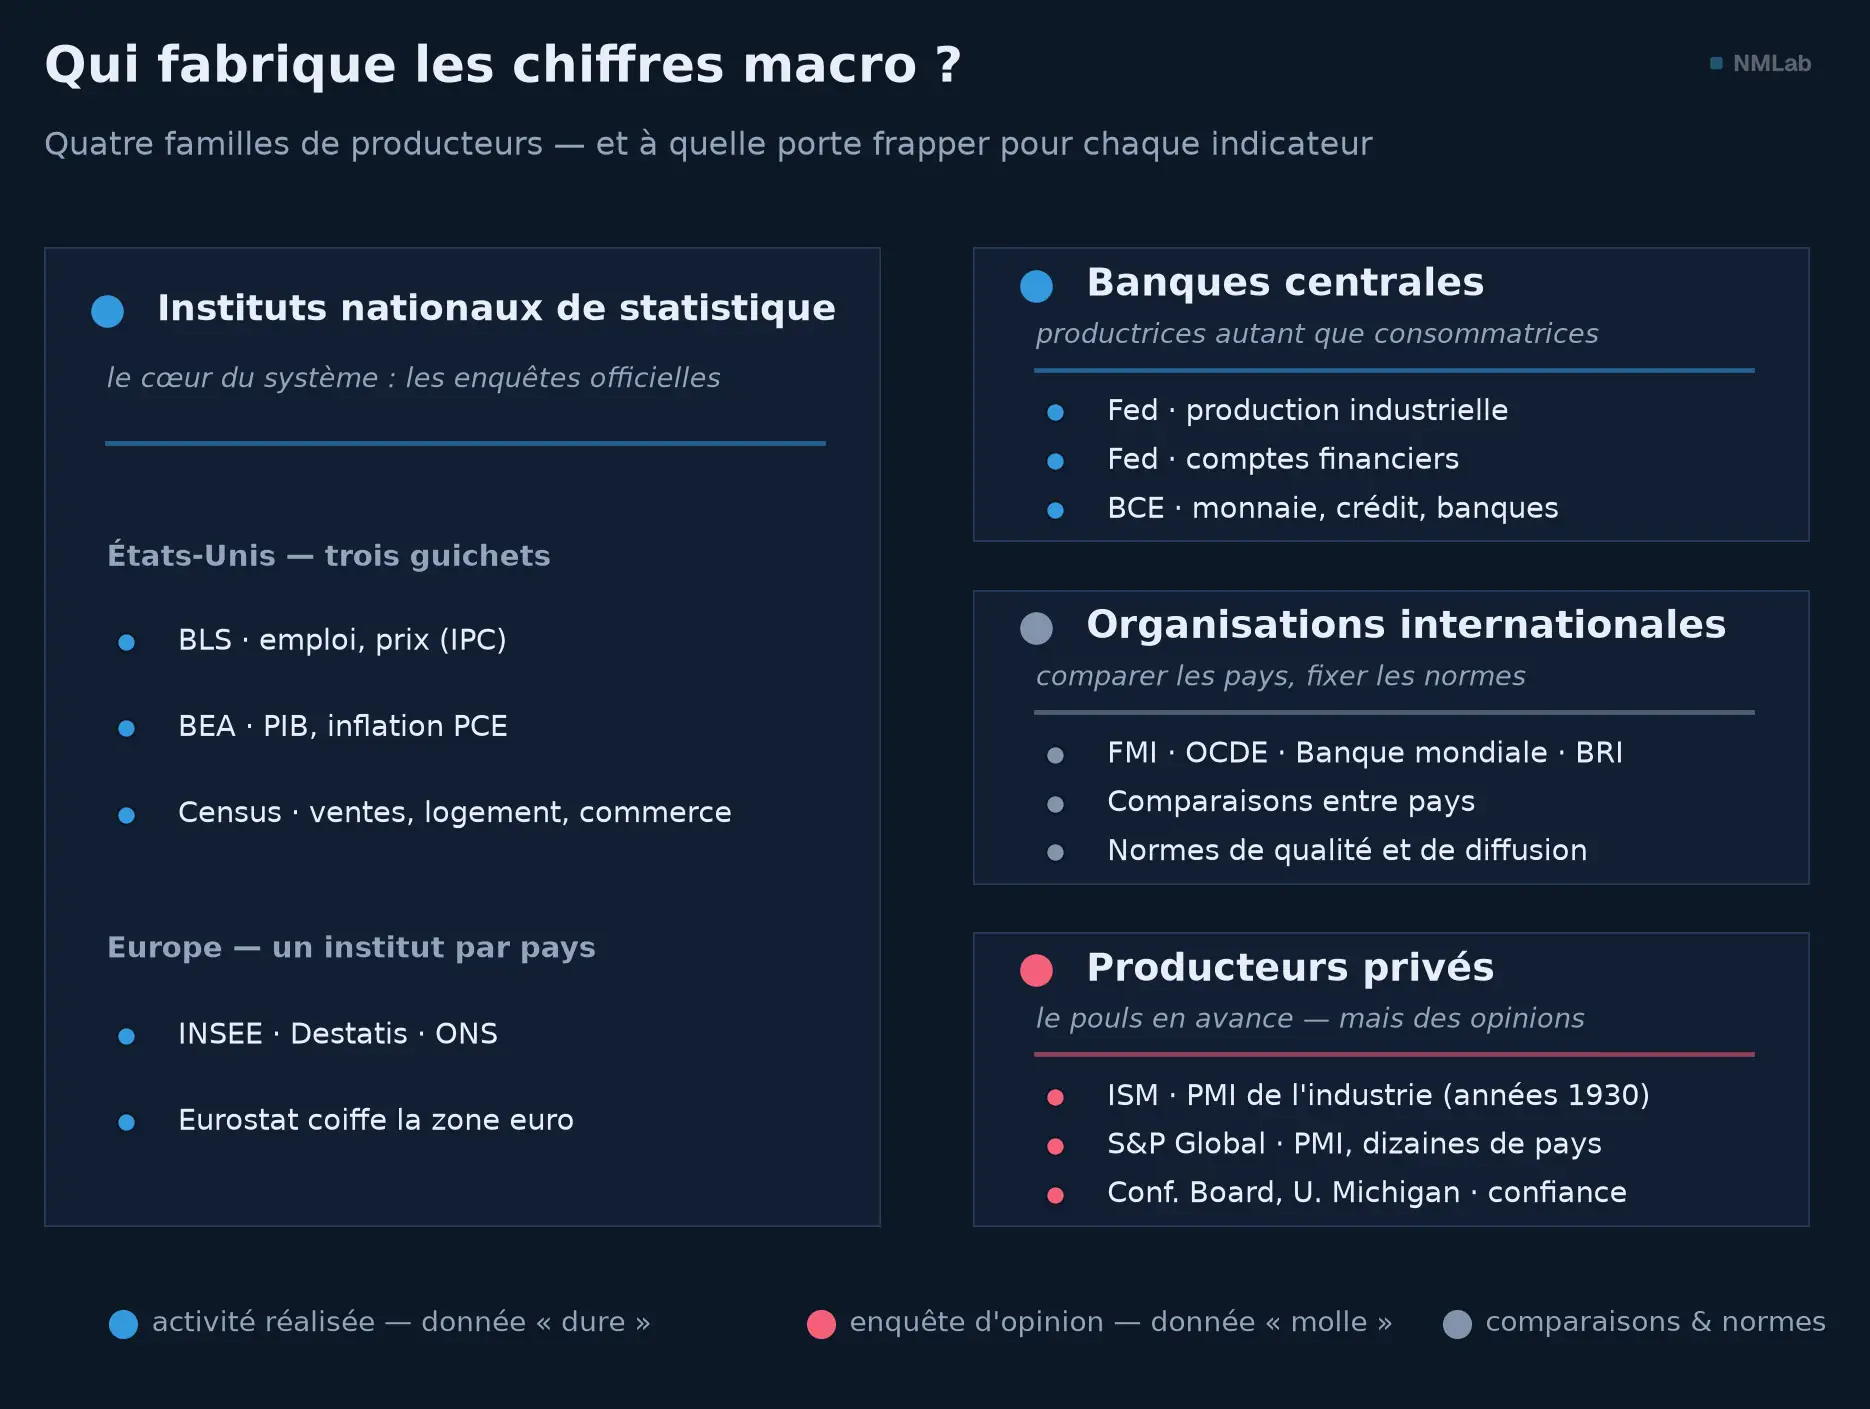
Les quatre familles qui alimentent le tableau de bord. Bleu = activité réalisée (« dure »), rouge = enquête d'opinion (« molle »), gris = comparaison et normalisation.
Ce qui tient l'ensemble : la déontologie statistique. Depuis 1994, les principes fondamentaux de l'ONU en font une obligation écrite : méthodes publiques, calendriers annoncés d'avance, accès simultané pour tous, pouvoir politique tenu à distance. C'est elle qui permet au marché de trader un chiffre officiel et au citoyen de demander des comptes ; nous verrons ce qui arrive quand elle cède.
La recette : sondages géants, registres et caisses enregistreuses
Trois matières premières se complètent. La première, la plus fragile : l'enquête. L'inflation américaine repose sur quelque 80 000 prix relevés chaque mois ; le taux de chômage, sur un sondage d'environ 60 000 ménages (l'enquête ménages) ; les créations d'emplois, sur l'enquête établissements, qui collecte les fiches de paie d'environ 120 000 employeurs. Le même rapport emploi contient donc deux enquêtes aux périmètres différents, qui peuvent raconter deux histoires le même mois — un chômage qui monte pendant que les embauches accélèrent, ou l'inverse.
Or un sondage, même géant, reste un sondage : déduire de 60 000 ménages la situation de 170 millions d'actifs, c'est extrapoler — donc accepter une marge d'erreur. Le BLS la publie : l'intervalle de confiance à 90 % sur les créations d'emplois mensuelles est de l'ordre de ± 130 000. Relisez-le : l'écart que le marché célèbre — « 180 000 emplois créés au lieu des 150 000 attendus » — est inférieur au flou de la mesure. Et partout, les taux de réponse s'érodent (celui de l'enquête ménages américaine est passé de plus de 90 % vers 70 % en quinze ans). Josiah Stamp (1929) plaisantait : au bout de la chaîne, quelqu'un inscrit « ce que bon lui semble » dans le formulaire. Exagéré — les instituts recoupent et redressent —, mais juste : une statistique vaut ce que valent ses déclarants.
Deuxième matière première, symétrique : le registre administratif — des données produites non pour mesurer, mais pour gérer. Les inscriptions hebdomadaires au chômage sont le comptage des demandes réellement déposées ; les douanes enregistrent chaque conteneur, le fisc voit passer salaires et chiffres d'affaires. Sources quasi exhaustives — pas d'échantillon, guère de marge d'erreur — mais étroites : elles ne voient que ce que l'administration gère, avec ses définitions, souvent avec retard. La statistique moderne marie donc les deux : l'enquête pour la rapidité, le registre pour l'exactitude — celui-ci recalant celle-là une fois l'an.
Troisième, la plus récente : la donnée massive. Depuis 2020, l'INSEE calcule une partie des prix français à partir des données de caisse des supermarchés — des millions de transactions réelles plutôt que des relevés d'enquêteurs. Alberto Cavallo et Roberto Rigobon (MIT) avaient ouvert la voie dès 2008 avec le Billion Prices Project, qui aspirait chaque nuit les prix des sites marchands — et démontra la manipulation de la statistique argentine en publiant une inflation alternative quotidienne. Cartes bancaires, offres d'emploi en ligne, images satellites : la panoplie s'élargit chaque année, en complément des enquêtes plus qu'en remplacement.
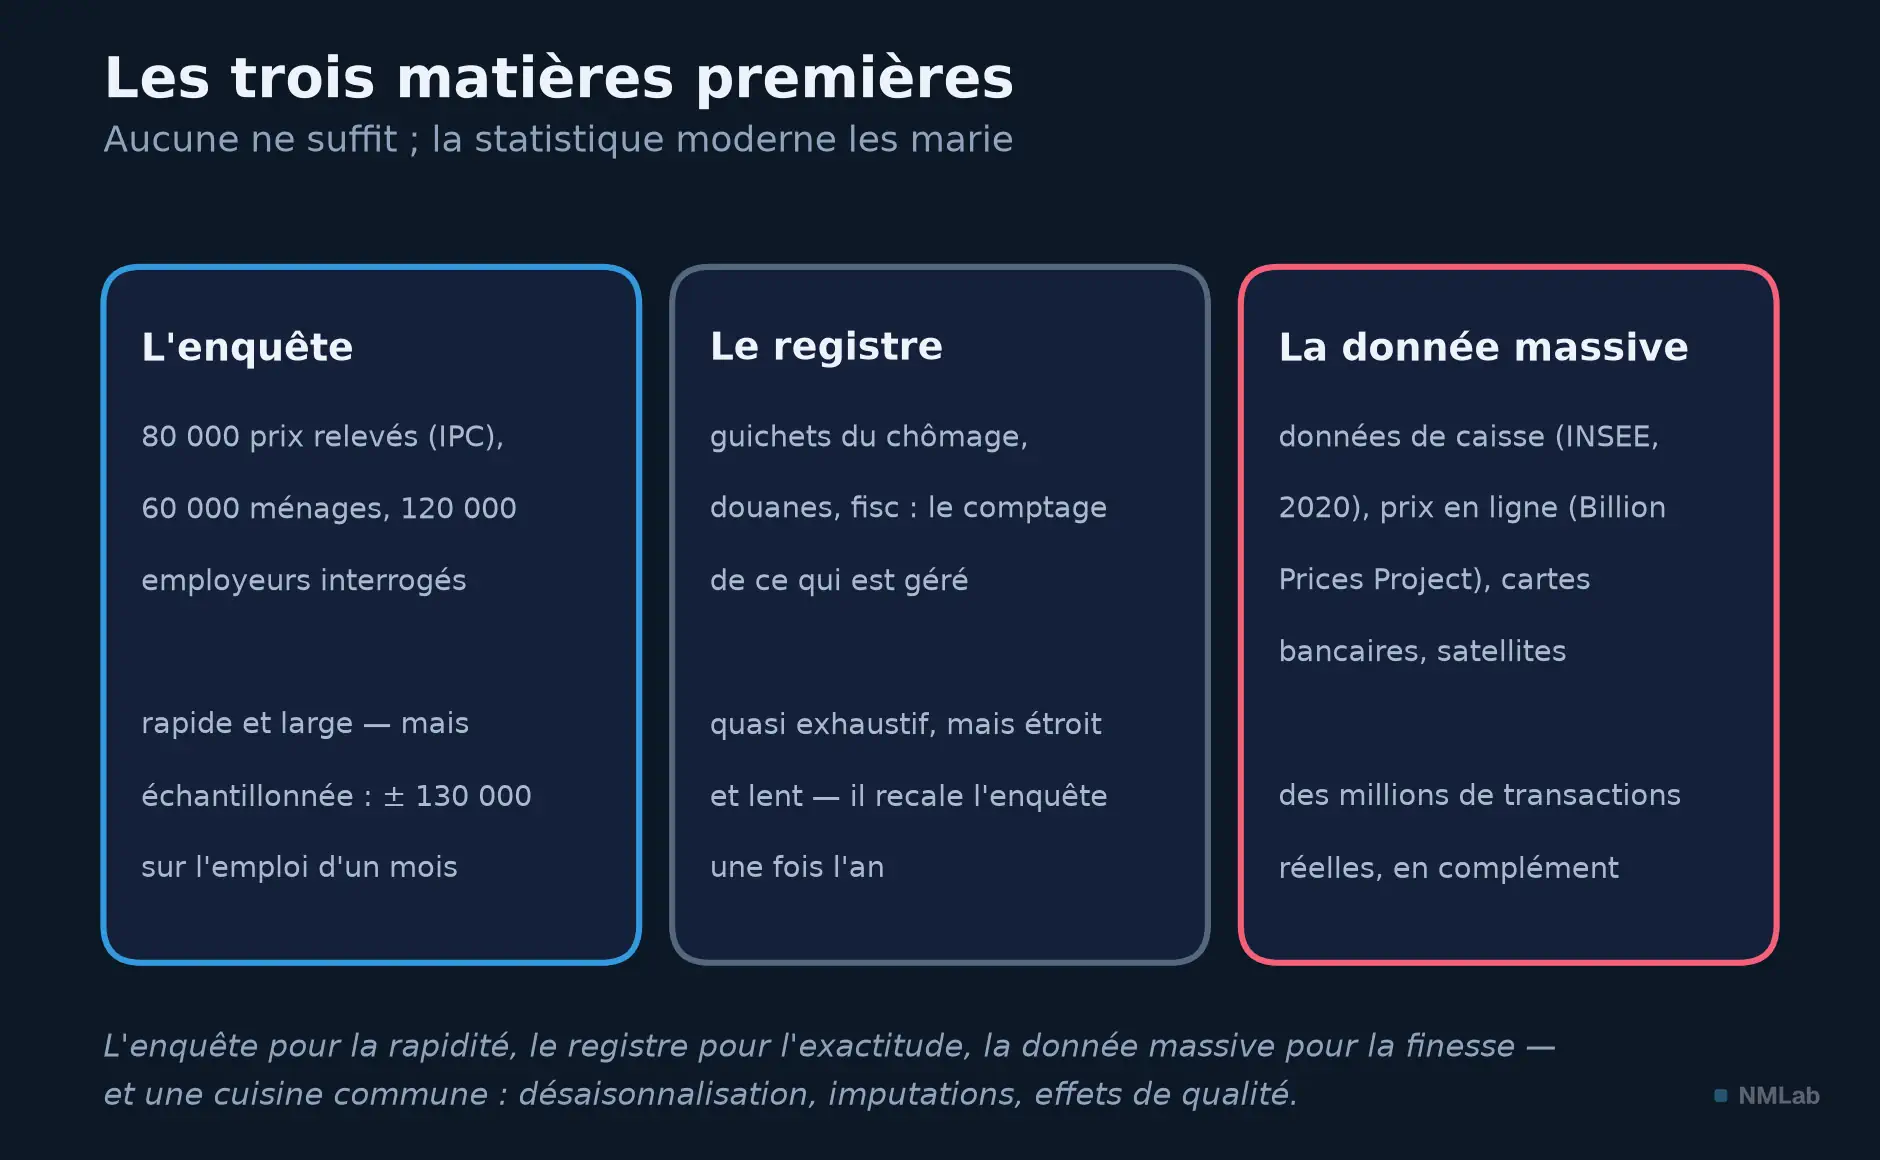
Trois matières premières, trois caractères : l'enquête va vite, le registre dit vrai, la donnée massive voit fin.
Reste la cuisine qui rend la matière brute publiable. On corrige des variations saisonnières (par des programmes du Census Bureau) pour que décembre ne ressemble pas à un boom du commerce ; on annualise ; on impute ce qui manque (un modèle estime les entreprises nées et mortes dans le mois) ; on ajuste les effets de qualité — si le nouveau téléphone coûte 5 % de plus mais fait deux fois mieux, quelle part est de l'inflation ? Chaque traitement est raisonnable, documenté — et faillible quand le monde sort de ses gonds. En avril 2020, l'Amérique détruisit plus de vingt millions d'emplois et le chômage bondit à 14,7 % — mais le BLS précisa, dans le communiqué même, qu'une erreur de classement (des licenciés temporaires comptés « avec emploi ») aurait dû le porter cinq points plus haut, vers 20 %. L'aveu, à chaud, dans le document officiel : la différence entre une statistique honnête et une statistique exacte.
Le calendrier : le mois type de l'investisseur
Chaque grande publication a son jour, son heure, sa fréquence, annoncés des mois à l'avance ; les marchés vivent à ce rythme. Voici le mois américain type.
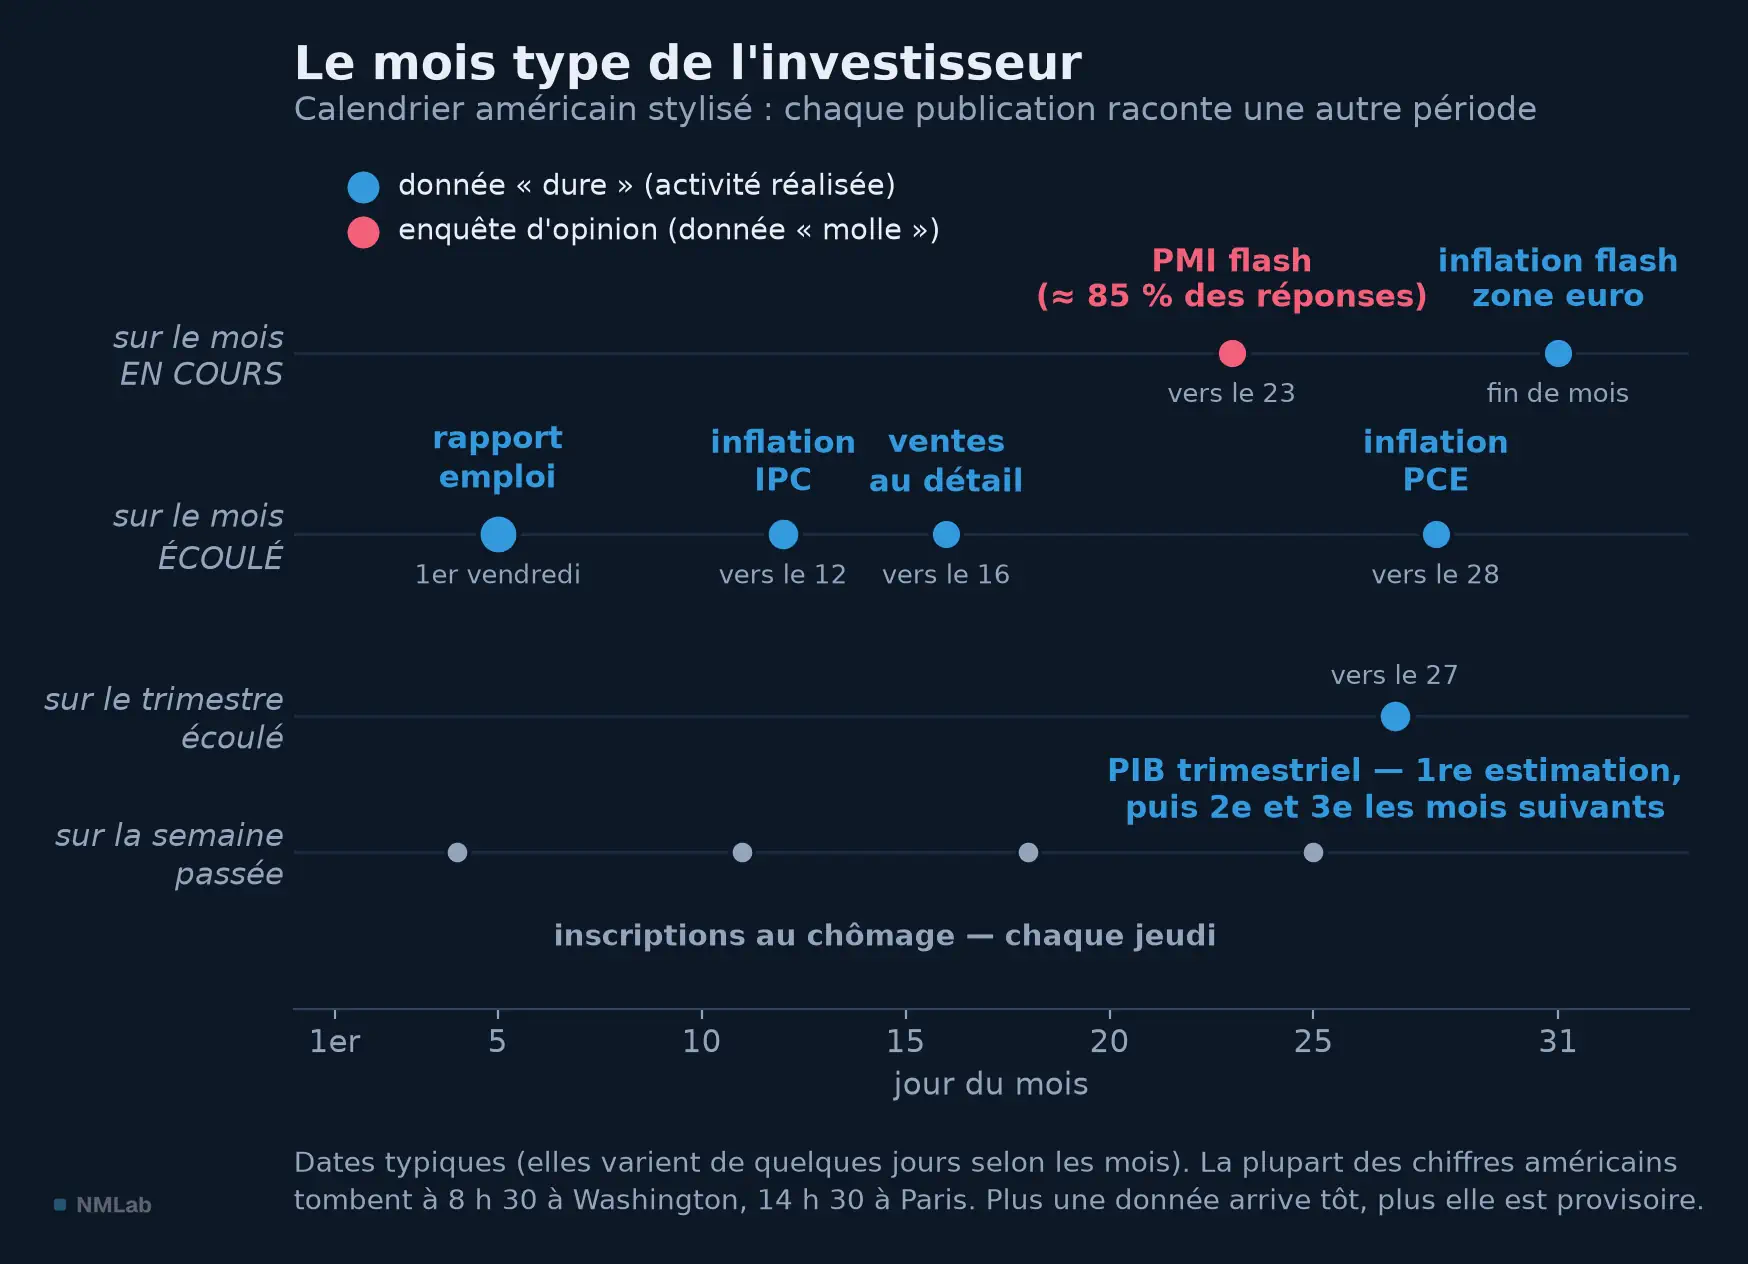
Le mois de l'investisseur : chaque pastille indique, par sa ligne, la période qu'elle raconte. Les enquêtes (rouge) devancent toujours les données réalisées (bleu).
Trois cadences s'emboîtent. L'hebdomadaire : chaque jeudi, les inscriptions au chômage — le pouls le plus rapide de l'économie américaine. Le mensuel, votre ossature : l'ISM ouvre le bal dès le premier jour ouvré, le rapport emploi règne le premier vendredi, l'IPC vers le 12, les ventes au détail à la mi-mois, l'inflation PCE — celle que la Fed cible — referme le mois. Le trimestriel : le PIB, un mois après la fin du trimestre, puis republié deux fois. L'Europe a son estimation flash de la zone euro dès le dernier jour du mois mesuré — les États-Unis n'ont pas de flash.
L'heure compte autant que le jour : la plupart des chiffres américains tombent à 8 h 30 à Washington (14 h 30 à Paris), sous embargo — dépêches et serveurs basculent au même instant, aucun acteur ne trade avant les autres. Condition pour que la surprise — l'écart au consensus — joue son rôle de choc pur. Les enquêtes arrivent avant les données dures : le PMI flash paraît vers le 23 du mois qu'il décrit, sur environ 85 % des réponses — mais il ne mesure qu'un ressenti. À l'autre bout, le PIB dit presque tout, presque définitivement, trois mois trop tard pour un trader. D'où le triangle qu'aucun chiffre ne résout : tôt, riche, définitif — il faut en choisir deux.
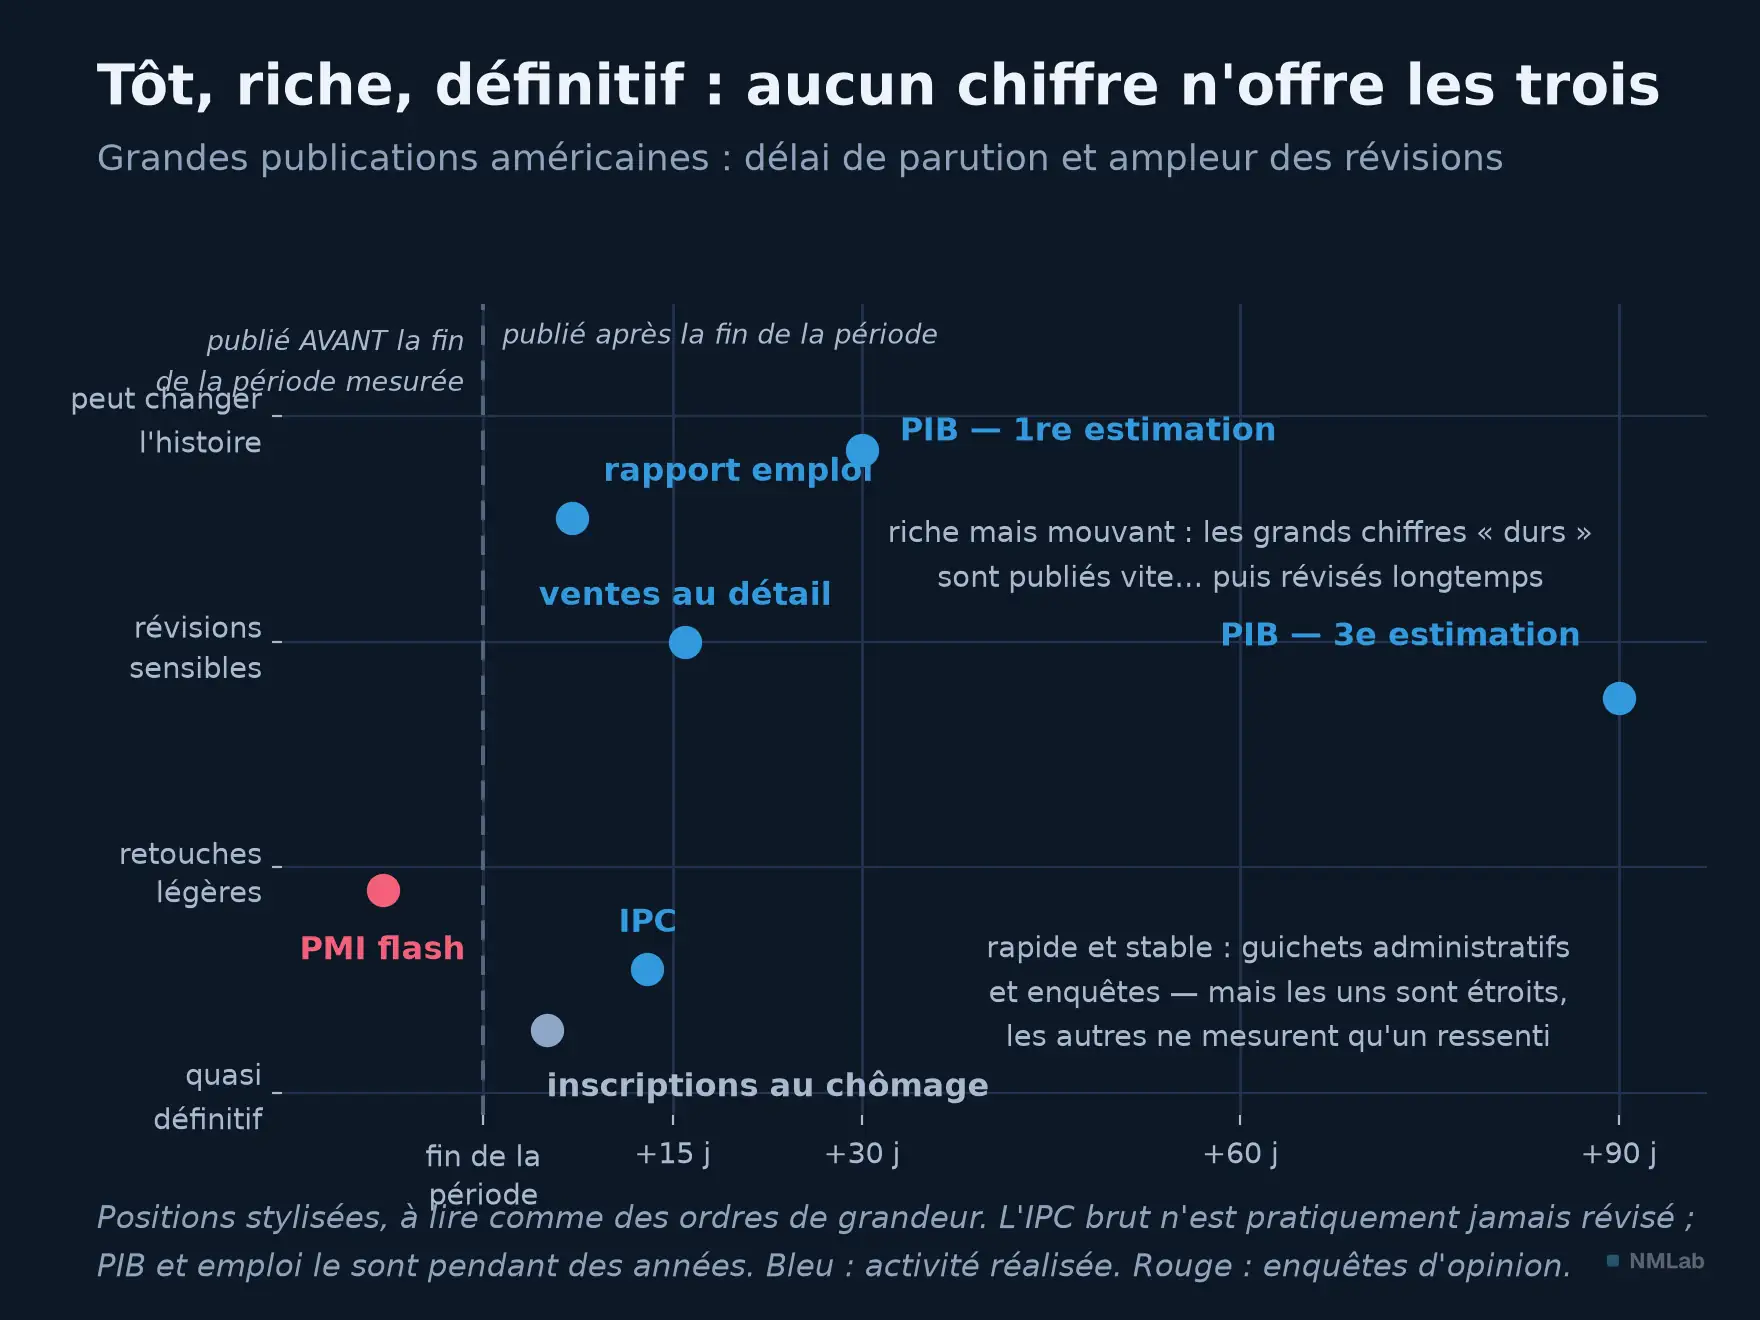
Le triangle impossible : le rapide et stable ne mesure qu'une humeur ou un périmètre étroit ; les grands chiffres durs sortent vite puis sont révisés des années. Exception : l'IPC, publié à douze jours et presque jamais retouché — d'où l'indexation de contrats.
La vérité est provisoire : au royaume des révisions
Le fait le plus troublant : les chiffres changent après leur publication — non par erreur, mais par construction. La première estimation combine les réponses arrivées à temps et des hypothèses pour boucher les trous ; puis les retardataires répondent, les sources lentes (bilans, fisc, registres sociaux) arrivent, les coefficients saisonniers se recalculent, et l'estimation est révisée — une fois, deux fois, puis lors de campagnes annuelles. Le PIB américain paraît en trois temps — avance, deuxième, troisième, à un mois d'intervalle — avant d'être repris chaque automne, des années durant. Selon le BEA, la révision moyenne entre la première estimation d'un trimestre et sa valeur d'aujourd'hui atteint un bon point de croissance annualisée — la frontière même entre « l'économie accélère » et « cale ».
Voici, sur données millésimées, les deux trimestres qui, à l'été 2022, ont mis « récession » à la une.
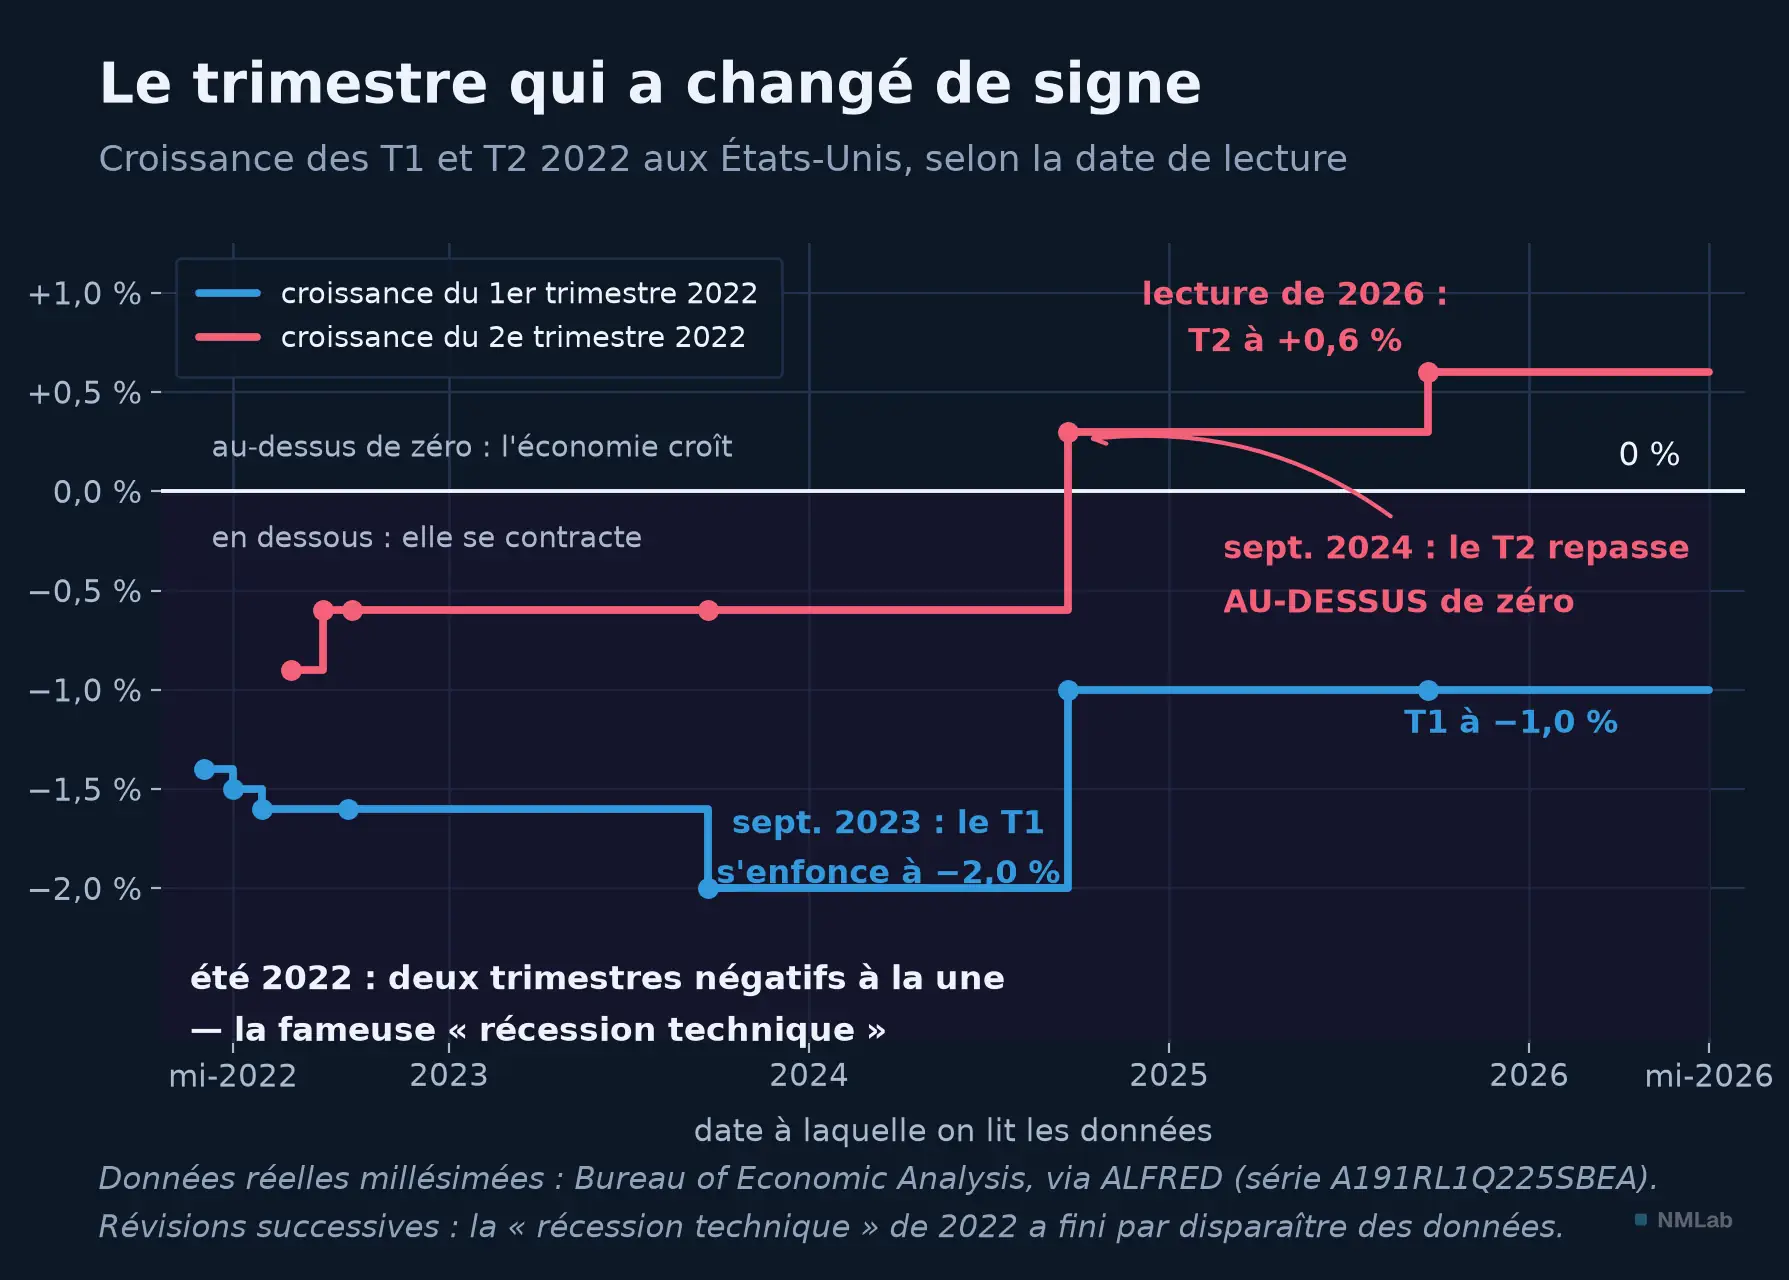
Le même semestre, lu à quatre ans d'écart. À l'été 2022, deux trimestres de recul (−1,6 % puis −0,9 % en première estimation) : récession technique, débat planétaire. Révision après révision, le T2 passe en positif en septembre 2024 et s'établit à +0,6 % en 2026 : la récession n'existe plus. Le NBER, lui, n'en avait jamais déclaré — l'emploi était trop solide.
Cette « récession technique fantôme » n'était donc pas qu'une affaire de définition, mais aussi de millésime : on a débattu des mois d'un fait qui, quelques révisions plus tard, avait cessé d'exister. Personne n'a menti — chaque estimation était la meilleure possible sur le moment. Mais l'histoire économique s'écrit au crayon, et il faut des années pour qu'elle passe à l'encre.
L'emploi vit la même vie : chaque chiffre mensuel est révisé les deux mois suivants, puis l'enquête entière est recalée une fois l'an sur les registres quasi exhaustifs de l'assurance chômage. Brutalement, parfois : en août 2024, le BLS retrancha −818 000 emplois sur l'année achevée en mars 2024 (la plus forte correction depuis 2009) ; en septembre 2025, l'exercice suivant en retrancha −911 000 sur l'année à mars 2025. Des centaines de milliers d'emplois célébrés en direct chaque premier vendredi n'ont jamais existé.
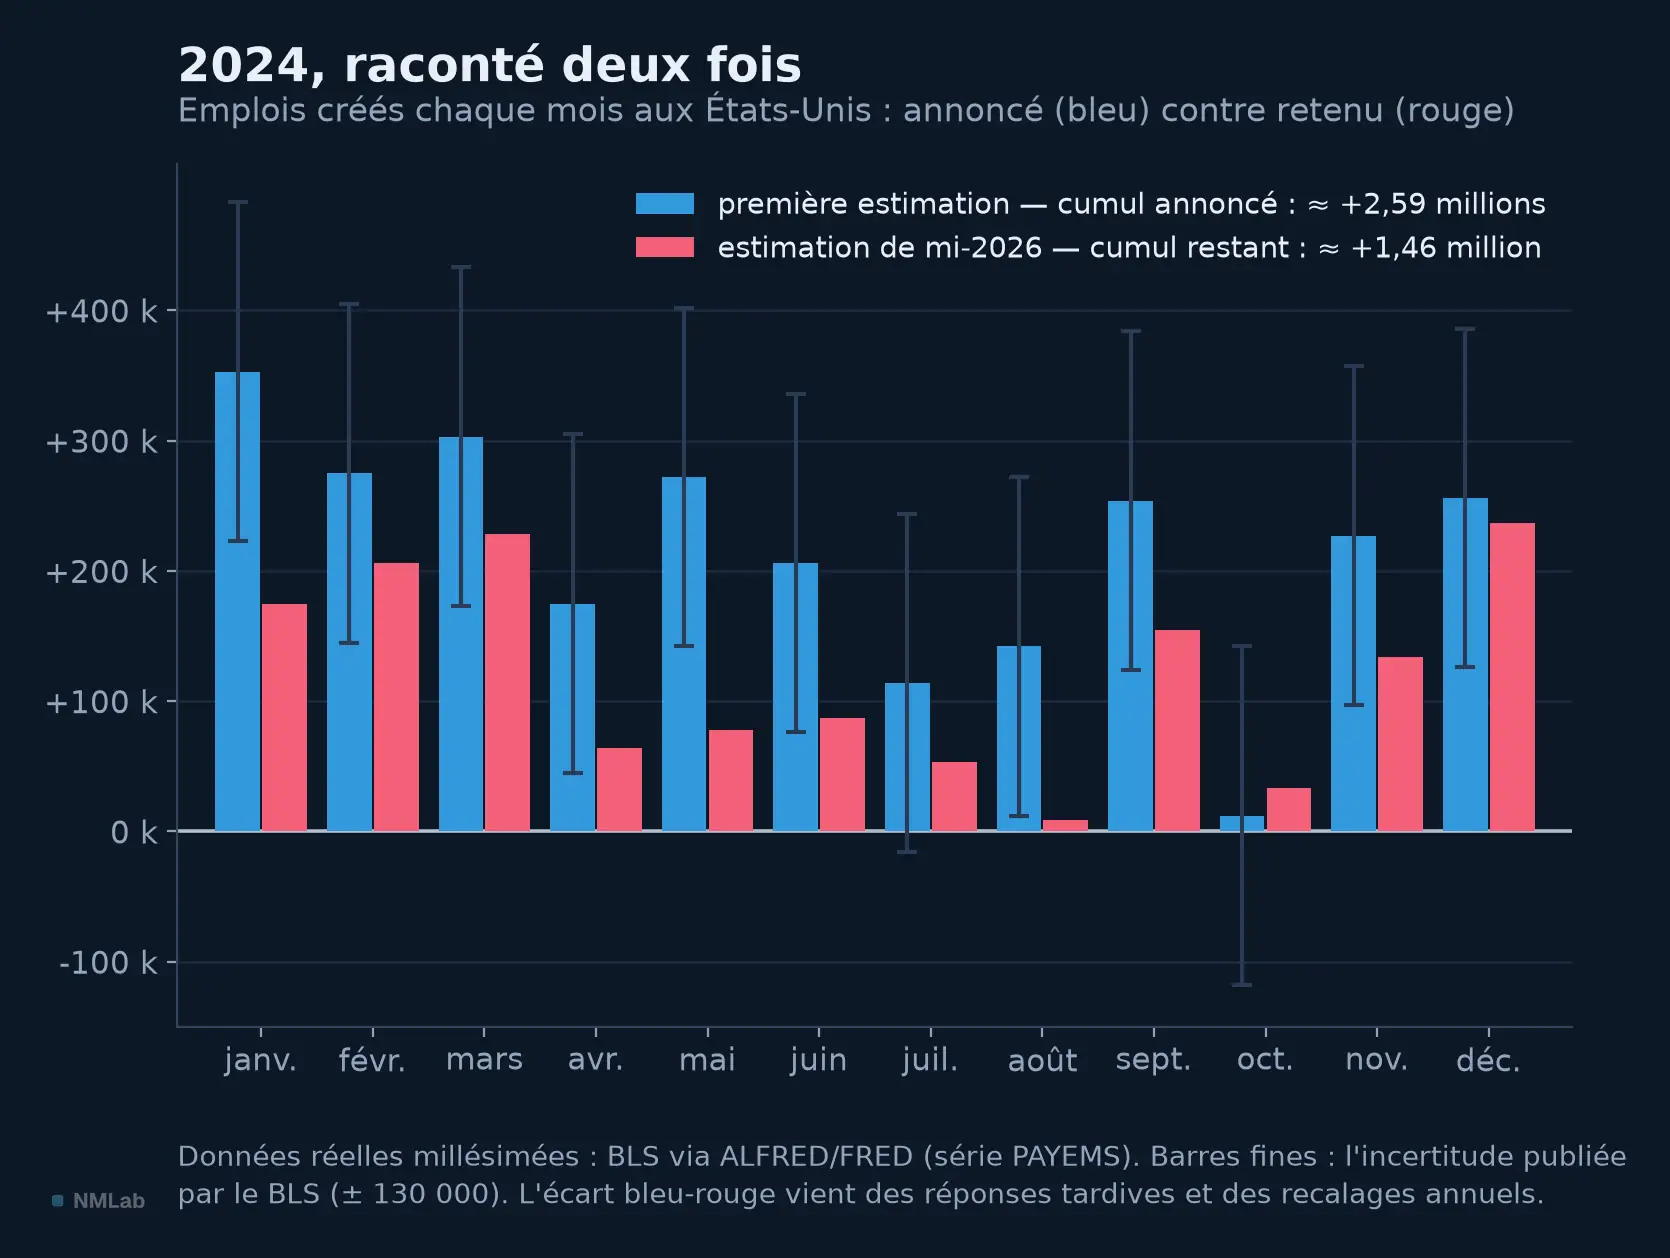
2024 telle qu'annoncée (bleu) et telle qu'on la lit aujourd'hui (rouge). ~2,6 millions d'emplois annoncés au fil des mois, 1,5 million restant à mi-2026 — réponses tardives et recalages annuels. Barres d'erreur du BLS, presque jamais citées : ± 130 000 par mois.
Le phénomène n'est pas américain : en 2023, l'office britannique découvrit que l'économie du royaume, donnée pour ~1 % sous son niveau d'avant-pandémie fin 2021, était en réalité au-dessus — deux points de PIB d'un trait de plume. Trois leçons. Les marchés tradent la première estimation : elle porte la surprise, donc le mouvement ; être démentie plus tard n'annule pas la séance. Les récits bâtis en temps réel reposent sur du provisoire : un faisceau d'indices est fiable là où le point isolé ne l'est pas. Enfin, le trou entre le trimestre écoulé et son premier PIB a fait naître le nowcasting : le GDPNow de la Fed d'Atlanta actualise depuis 2014 le trimestre en cours — une estimation d'une estimation.
Dernier piège, pour les lecteurs quantitatifs : le millésime en backtest. Tester une stratégie sur les données actuelles, c'est utiliser des chiffres que personne ne connaissait à l'époque. Ce biais d'anticipation embellit les backtests. La parade : les bases millésimées comme ALFRED, l'archive de la Fed de Saint-Louis, qui conserve chaque état passé de chaque série et a fourni les figures de ce chapitre. Réflexe : utiliser les données telles qu'elles étaient, pas telles qu'elles sont devenues.
Jusqu'où s'y fier ? Erreurs honnêtes et chiffres sous influence
Tout ce qui précède décrit des erreurs honnêtes. Mais entre l'imprécision de bonne foi et le mensonge d'État s'étend un continuum.
Côté bonne foi, les débats de mesure, permanents et publics. En 1996, la commission Boskin conclut que l'IPC américain surestimait l'inflation d'environ 1,1 point par an (biais de substitution, de qualité, de nouveaux produits), d'où des réformes qui pesèrent sur tout ce que l'IPC indexe, des retraites aux tranches d'impôt. Autre exemple : le logement pèse près d'un tiers de l'IPC américain, et sa méthode y fait entrer les loyers avec un an de retard — en 2021-2023, l'inflation officielle du logement a continué d'accélérer longtemps après le ralentissement des loyers de marché, la Fed pilotant sur un thermomètre en retard. Même les identités comptables vacillent : le revenu intérieur brut, censé égaler le PIB, s'en est sensiblement écarté en 2022-2023. Ajoutez la loi de Goodhart (1975) : quand une mesure devient un objectif, elle cesse d'être une bonne mesure.
Côté mauvaise foi, trois cas gradués. La Grèce d'abord : au printemps 2009, Athènes notifiait à Bruxelles un déficit prévu d'environ 3,7 % du PIB ; à l'automne, le nouveau gouvernement révélait plutôt 12,7 % ; après enquêtes d'Eurostat, l'histoire s'arrêta à 15,4 %. Non pas une révision, mais un maquillage au long cours — l'étincelle de la crise de la zone euro ; depuis 2010, Eurostat a de vrais pouvoirs d'audit sur les comptes nationaux. L'Argentine ensuite : à partir de 2007, le gouvernement mit au pas son institut pour minorer l'inflation et amenda les économistes privés qui publiaient leurs propres mesures ; il récolta en février 2013 une motion de censure du FMI — la première de son histoire pour données mensongères, levée seulement fin 2016. La fraude a un tarif : un pays dont les chiffres mentent emprunte plus cher, car le doute est une prime de risque. La Chine enfin : en 2007, le futur Premier ministre Li Keqiang confiait à l'ambassadeur américain, selon un câble WikiLeaks, que le PIB de sa province était « fabriqué par l'homme » et qu'il lui préférait trois séries dures à maquiller — électricité, fret ferroviaire, crédits bancaires. Quand le thermomètre officiel est suspect, on recoupe par des grandeurs physiques que personne ne pense à truquer.
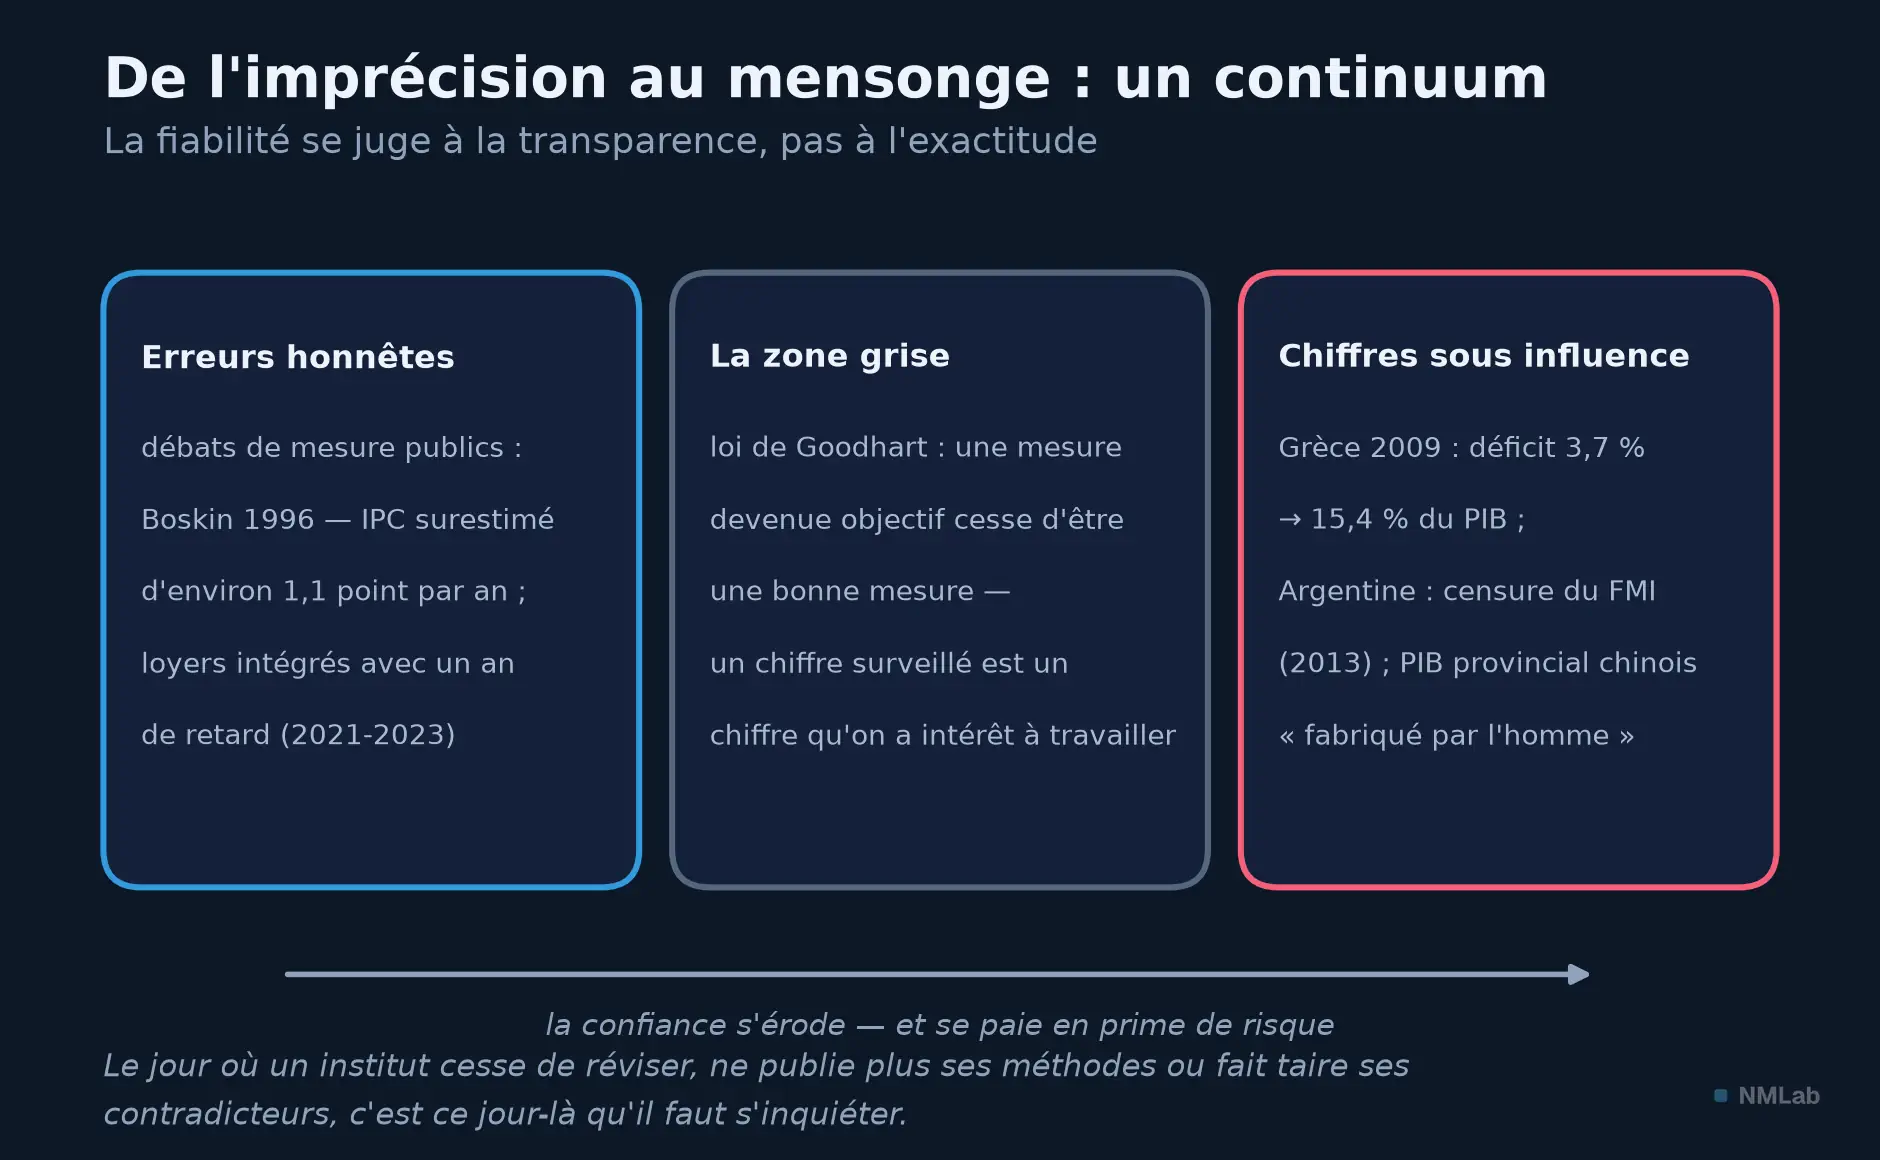
L'imprécision de bonne foi se débat en public ; le maquillage se paie en prime de risque. Entre les deux, la loi de Goodhart veille.
L'indépendance statistique s'est rappelée récemment à la première puissance mondiale. À l'été 2025, un rapport emploi décevant, assorti de fortes révisions baissières, fut suivi le jour même du limogeage de la directrice du BLS par le président américain, qui l'accusa sans preuve de truquer les chiffres ; à l'automne, un blocage budgétaire record suspendit des semaines les publications fédérales — marchés et banque centrale dans le brouillard, certaines observations d'octobre définitivement perdues. La leçon : la crédibilité d'une statistique nationale est une infrastructure publique, comme un réseau électrique — invisible tant qu'elle fonctionne, hors de prix à reconstruire.
D'où le verdict. Les chiffres des grandes démocraties statistiques sont fiables — non qu'ils soient exacts, mais parce que leurs défauts sont publics : méthodes documentées, marges d'erreur publiées, révisions assumées, normes internationales de diffusion (le FMI en tient une depuis 1996). La transparence sur l'imperfection est ce qui sépare la statistique de la propagande. Le jour où un institut cesse de réviser, ne publie plus ses méthodes ou fait taire ses contradicteurs, il faut s'inquiéter.
La boîte à outils : trouver les chiffres, et les lire sans se faire piéger
Où trouver tout cela ? Gratuitement, souvent mieux que les services payants. La porte d'entrée universelle est FRED, la base de la Fed de Saint-Louis : des centaines de milliers de séries exportables, et sa sœur ALFRED conserve les millésimes ; Eurostat, la BCE et l'INSEE offrent l'équivalent européen. Pour le rythme, un calendrier économique vous prévient : date, heure, consensus, valeur précédente de chaque publication. Pour la méthode, chaque communiqué du BLS ou du BEA porte ses notes techniques et ses marges d'erreur.
Six réflexes, qui prolongent ceux du lexique. Un : identifiez ce que vous lisez — niveau ou variation, brut ou désaisonnalisé, glissement annuel ou rythme annualisé. Deux : comparez au consensus, jamais à zéro ni au seul mois précédent — c'est la surprise qui meut les marchés. Trois : respectez la marge d'erreur — un chiffre isolé est du bruit, trois mois de moyenne un début de signal, six mois cohérents une tendance. Quatre : la première estimation sera révisée — ne bâtissez pas une conviction définitive sur un chiffre provisoire. Cinq : croisez le mou et le dur — une enquête qui plonge sans que les données réalisées suivent est une humeur, pas encore un fait. Six : en recherche quantitative, utilisez les données de l'époque, pas celles d'aujourd'hui.
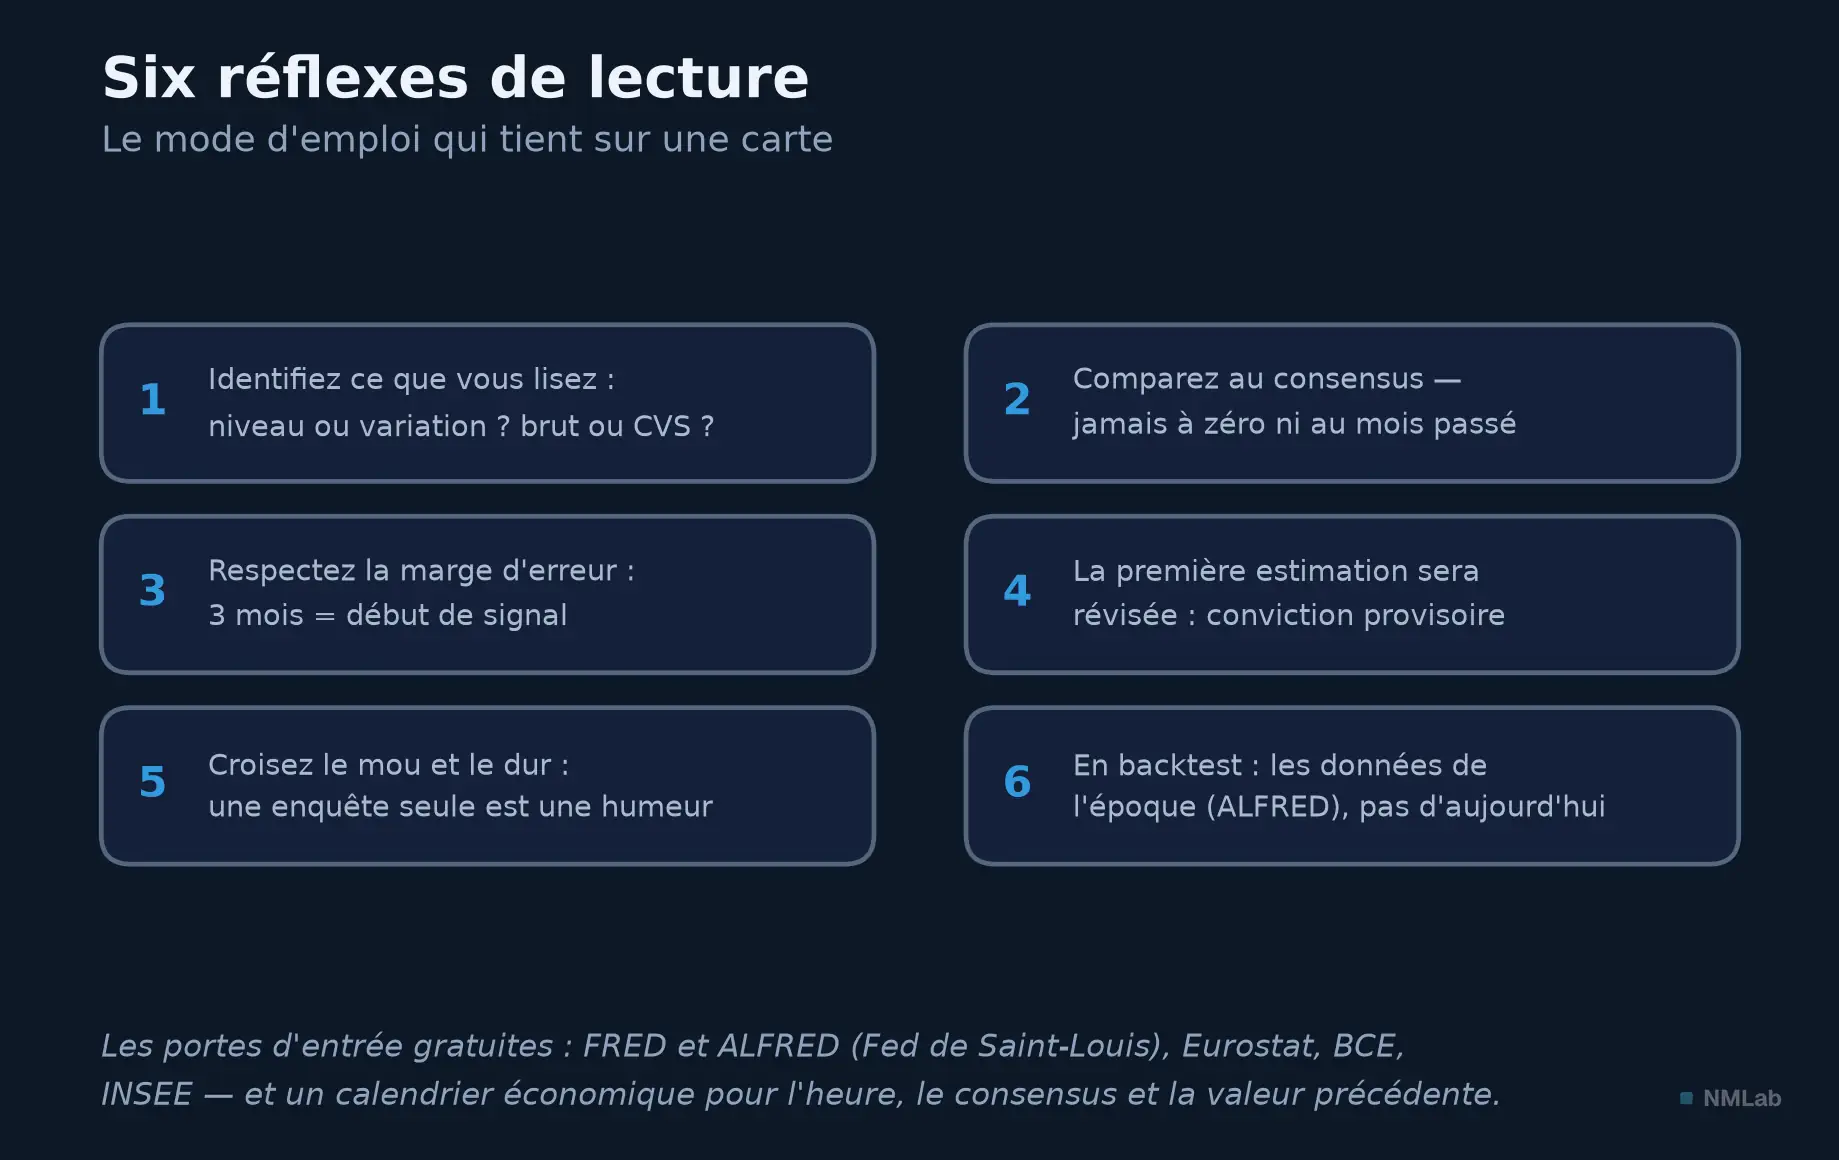
Six réflexes à coller près de l'écran — et des portes d'entrée gratuites pour tout vérifier soi-même.
À retenir
- Une estimation manufacturée, pas un fait de nature — Le PIB n'existe pas dans la nature : personne n'a jamais croisé un taux de chômage dans la rue. Échantillonné, corrigé, désaisonnalisé : le chiffre est un produit fini.
- La fabrique, et son rituel — Enquêtes géantes, registres, données de caisse, puis des traitements documentés et faillibles ; livrés à jour et heure annoncés des mois à l'avance — une liturgie qui rythme les marchés.
- Les révisions — La première version fait bouger les marchés : elle porte la surprise face au consensus. La version finale écrit l'histoire ; les deux peuvent différer du tout au tout, comme la « récession » américaine de 2022, disparue des données. L'histoire économique s'écrit au crayon, et il faut des années pour qu'elle passe à l'encre.
- La marge d'erreur, publiée et ignorée — ± 130 000 sur les créations d'emplois d'un mois, parfois plus large que la surprise célébrée. Toute la différence entre une statistique honnête et une statistique exacte.
- La fiabilité se juge à la transparence — Méthodes publiques, révisions assumées, institut indépendant. Traitez chaque publication comme un témoignage sous serment — précieux, daté, faillible —, jamais comme un verdict.
La suite du voyage
Ce chapitre clôt l'inventaire des fondations : pourquoi la macroéconomie pilote vos placements, à quelle échelle elle raisonne, quelles variables peuplent son tableau de bord — et d'où sortent ses chiffres. Reste à en faire une habitude : ce sera l'objet du prochain chapitre, « Module 1 en pratique : se bâtir une routine de veille macro ». D'ici là, gardez la règle de ce chapitre : derrière chaque chiffre macro, demandez-vous qui l'a fabriqué, à partir de quoi, s'il sera révisé — et lisez l'écart au consensus avant le chiffre lui-même.
Sources et références
- Simon Kuznets, National Income, 1929-1932 (rapport au Sénat des États-Unis, 1934) — acte de naissance de la comptabilité nationale américaine.
- Oskar Morgenstern, On the Accuracy of Economic Observations (Princeton University Press, 2e éd. 1963).
- Josiah Stamp, Some Economic Factors in Modern Life (1929).
- Bureau of Labor Statistics, The Employment Situation — notes techniques (échantillons ménages/établissements ; intervalle de confiance à 90 % de ± 130 000 en 2024, ± 122 000 dans les notes récentes) ; communiqué d'avril 2020 (8 mai 2020) documentant l'erreur de classement pandémique (~5 points).
- Bureau of Labor Statistics, recalages annuels préliminaires de l'enquête établissements : −818 000 emplois (août 2024, année à mars 2024), −911 000 (septembre 2025, année à mars 2025).
- Dennis Fixler, Ryan Greenaway-McGrevy & Bruce Grimm, « The Revisions to GDP, GDI, and Their Major Components », Survey of Current Business (BEA, 2014) — ampleur des révisions du PIB américain.
- Commission Boskin, Toward a More Accurate Measure of the Cost of Living (1996) — surestimation de l'IPC américain d'environ 1,1 point par an.
- Charles Goodhart, « Problems of Monetary Management: The U.K. Experience » (1975).
- Eurostat, Report on Greek Government Deficit and Debt Statistics (janvier 2010) — falsifications grecques ; déficit 2009 établi à 15,4 % du PIB.
- Fonds monétaire international, censure de l'Argentine (février 2013, levée en novembre 2016) — première censure du FMI pour données mensongères.
- Alberto Cavallo & Roberto Rigobon, « The Billion Prices Project », Journal of Economic Perspectives (2016).
- The Economist, « Keqiang ker-ching » (décembre 2010) — le câble de 2007 (WikiLeaks) sur le PIB provincial « fabriqué par l'homme ».
- Données des figures : BEA (PIB, série A191RL1Q225SBEA) et BLS (emploi, série PAYEMS), millésimes via ALFRED/FRED, Federal Reserve Bank of St. Louis.